
共识重建:大模型的Flash版,一个比一个能打

不知道你有没有发现,过去几个月,国产模型的Flash版正变是越来越能打。Flash,本意是快,放到模型领域就是效率第一,这个效率是牺牲质量换来的。8月,Deepseek V4 flash正式版上线改变了这一切。
Deepseek V4 flash正式版在多项基准测试和实际复杂任务中展现出接近甚至超越V4 Pro预览版的强悍实力。同月,智谱GLM 5.3 flash和Qwen 3.8 flash上线,再次惊艳众人。9月,云知声的U2 flash上线,它基于U2通用基座,通过系统性后训练实现能力与效率的同步升级。U2 flash不是U2的轻量版,而是面向真实任务的新一代高性能主力模型。
市场正在达成一个新共识:Flash将从效率版本走向主力智能。
以最新的U2 flash为例,它在推理、Agent执行与复杂任务能力进一步提升的同时,兼顾响应速度、任务完成效率与使用成本,面向高频真实任务提供“又好又快”的任务交付体验。换句话说,用户每一个token的消耗,都在驱动一个真正具备多领域能力的模型在工作。
这一切是怎么实现的呢?具体到U2 flash,答案是后训练,是递归自我改进(RSI)。后训练(Post-training),是 U2-Flash 释放高密度智能的核心引擎,在递归自我改进(RSI)方向迈出重要一步,模型本身不只是补训练的对象,而是训练闭环的参与者,加速模型的自我进化。
从趋势上看:中国模型正在进入“Flash时刻”。
作为用户,倪叔好奇:这么多Flash版模型,谁更强?作为一个科技媒体,倪叔更好奇:这一切是怎么发生的?又将给市场带来哪些改变?后训练×RSI在具体细节上发挥了怎样的作用?为了解答心中疑问,以云知声U2-Flash上线为契机,倪叔对几款主流的Flash版模型做了一次横评,同时对市场进行了一次深入调查,于是有了今天这篇文章。
1
横评:国产Flash模型哪家强?
上个周末,倪叔针对DeepSeek V4.1 flash、U2 flash和GLM 5.3 flash做了三轮横评,分别测试他们在生图生视频、调研分析及应用开发三个场景的能力。DeepSeek V4.1 flash综合能力最优,U2 flash和GLM 5.3 flash不相上下——行业调研报告一轮略胜GLM 5.3 flash。
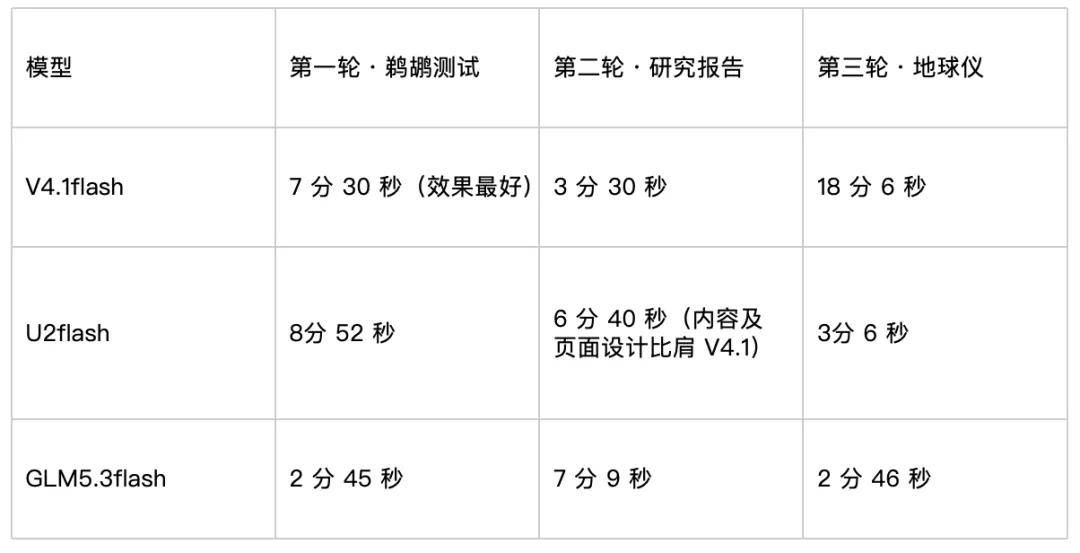
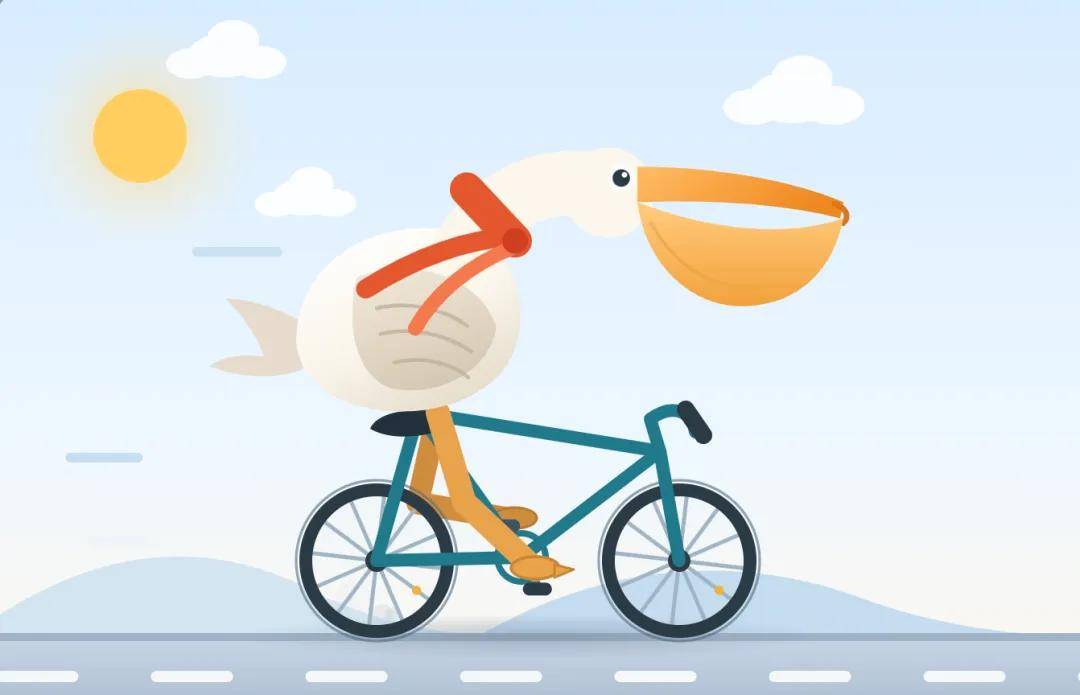
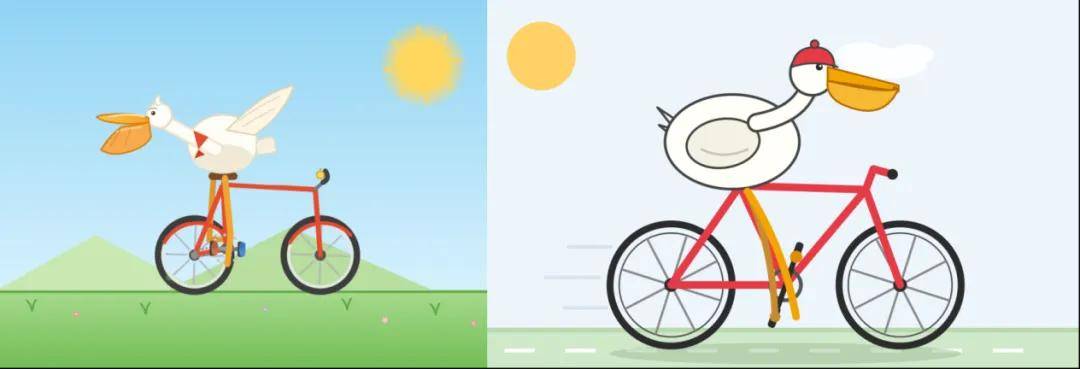
第一轮测试是经典的鹈鹕测试,让三个模型分别生成鹈鹕骑自行车的SVG视频,DeepSeek V4.1 flash的生成堪称完美,鹈鹕和自行车的大小比例非常舒适,骑行姿态流畅;U2 flash和GLM 5.3 flash遇到了两相相同的问题,一是大小比例欠缺,二是脚虽然够到了踏板但没有骑行的动作。——从时间上看,GLM 5.3 flash比U2 flash用时更短。
第二轮测试是让他们调研办公AI行业的发展,生成调研报告html。三份html太长了,图文空间有限就不放了,这里只说结果:DeepSeek V4.1 flash和U2 flash的报告质量相当,但后者用时是前者的两倍,GLM 5.3 flash与U2 flash用时相当,但给到的报告更像是一个未完成的草稿。
第三轮测试我让他们各生成了一个星空网页,结果如下:
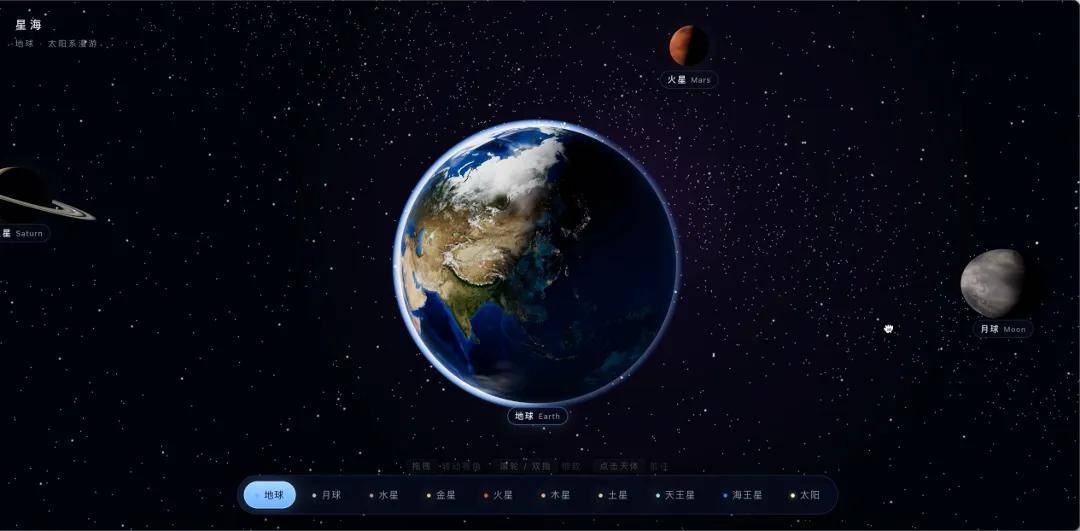
DeepSeek V4.1 flash
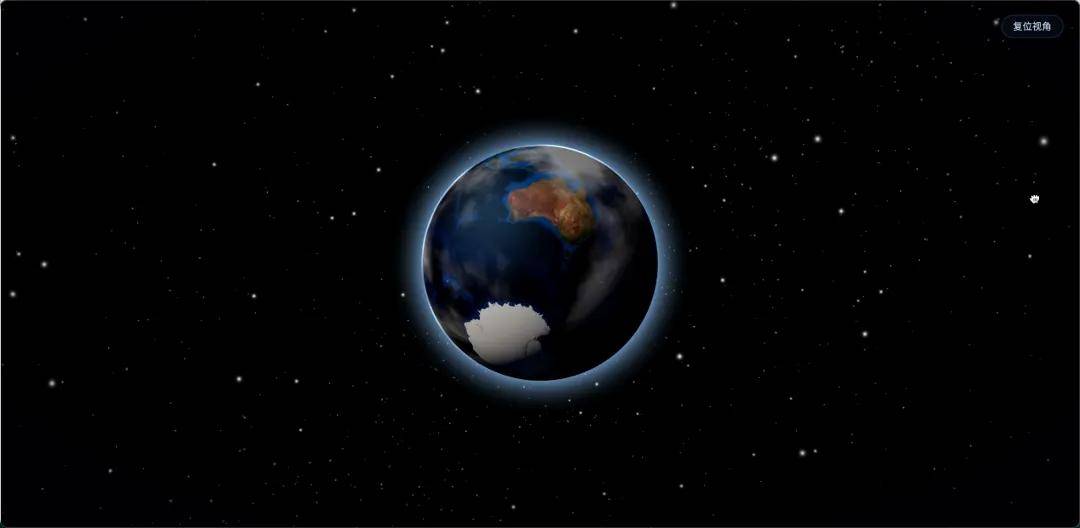
U2 flash
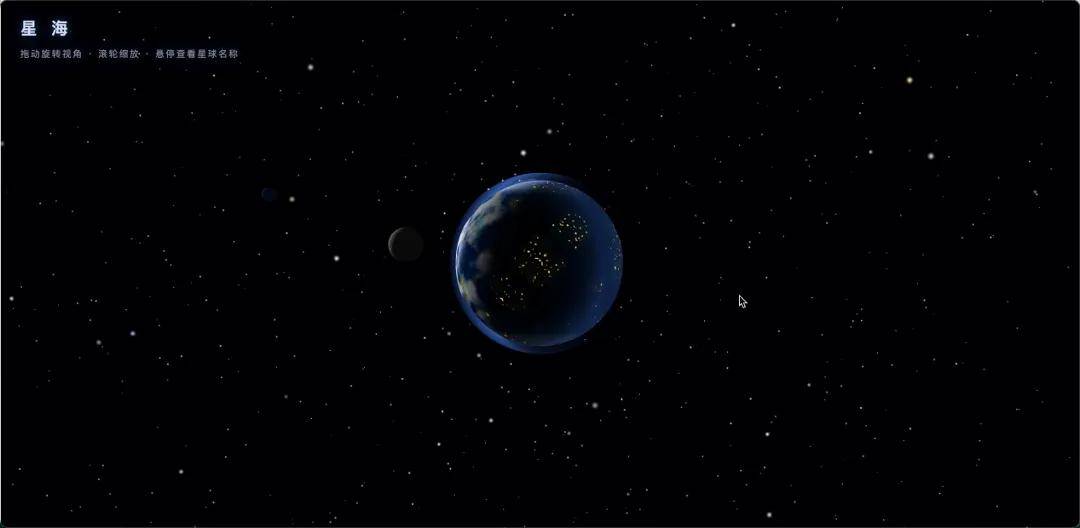
GLM 5.3 flash
DeepSeek V4.1 flash断层领先,从效果上看U2 flash的星空图比GLM 5.3 flash更有美感,细节上更丰富一些。
倪叔的实测中,DeepSeek V4.1 flash最优,U2 flash次之,GLM 5.3 flash再次之。排名虽然分了一个先后,但综合能力上看,其实差距并不算太大。这里我们必须要注意,U2 flash和GLM 5.3 flash与公认国产最强模型DeepSeek V4.1 flash对比测试能拿到这样一个结果,说明国产flash模型的整体水平已经在线了。一句话总结:能用,能打。
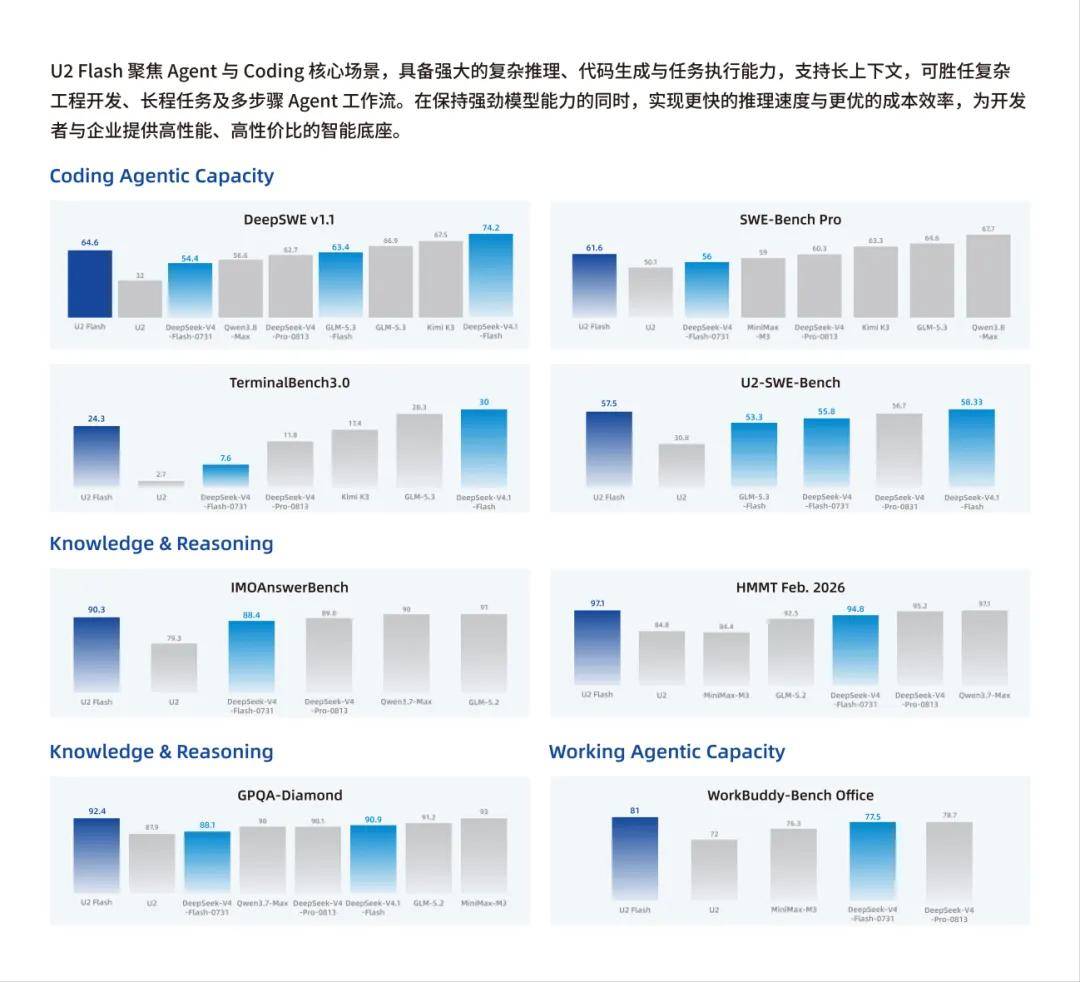
国际多数主流模型测评榜单中,U2 flash和GLM 5.3 flash均能打入前三名,9月新发布的U2 flash在部分榜单中能挤入第二和第一,甚至压过DeepSeek V4.1 flash一头。国产flash模型,正在集体发力争上游。
到这里,第二个问题呼之欲出了:是什么导致了这一切?为什么过去两个月国产flash模型一次又一次刷新人们的认知,建立新共识?
在U2 flash身上,我们或许能找到这个答案。
2
外部倒逼内部,国产模型集体转向“存量算力压榨”
U2 flash有三个亮点:
能接住更复杂、更长链路的真实任务;
不是单纯跑得快,而是又好又快地把任务做完;
更优成本:用更少 Token 交付同样甚至更好的结果。
U2 Flash采用稀疏混合专家(Sparse MoE)架构,总参数约 266B,激活参数仅 10B。这一架构设计的核心优势在于高智能密度:模型在每次推理时只激活少量专家参数,却能将编程、Agent、数学推理、指令遵循等多领域能力统一承载在同一套权重中,以远低于稠密大模型的计算开销,交付接近顶级模型的任务完成质量。
总结就是:速度更快、成本更低、能力更强。
那怎么才能实现呢?对“存量算力的极致压榨”。
实现方式,就是开篇讲过的后训练。
这是一条被倒逼出来的路,起源于众所周知的技术封锁。为了突破国际市场的技术限制,为了在有限算力中拿到更强结果,后训练成为不得不选的路。U2 Flash的后训练能力已经和智谱、DeepSeek相当,DeepSeek V4.1 flash、GLM 5.3 flash都是通过这条技术路线拿到结果的典型。如何在有限条件下拿到更好的结果,是国产模型都在思考的问题。
当国外厂商依靠海量算力“堆参数、堆显存”的时候,国产厂商开始了精细化的后训练,U2 Flash进化出了五条路线。
自主闭环演进:围绕薄弱能力持续迭代;
异步 Agent RL:学习多解法,让任务更快收敛;
多教师在线策略蒸馏:把多领域能力汇聚到统一模型;
自适应任务生成:让训练难度随模型能力一起进化;
全流程自我运维:Agent 能力反哺训练流程;
U2-Flash将后训练作为释放模型能力的关键抓手,通过系统性训练机制进一步强化模型的理解、规划与执行能力。在这个过程中,U2-Flash建立了一套自主闭环演进机制,从被训练对象变成任务生成、轨迹分析与纠错重彩的深度参与者。目前,U2-Flash已自主构建出覆盖主流编程语言、规模近10万的高质量 SWE 任务集。
从结果看,U2-Flash迈出了递归自我改进(RSI)的第一步,所有改进都能在真实沙盒中复现验证,云知声在这个基础上,逐步扩大模型参与自身能力成长的范围,实现真正的持续性进化。
所有这一切,建立在云知声十余年的行业深耕,过去积累的海量真实场景数据与高质量标注能力,成为U2-Flash后训练不可替代的数据质量壁垒。好数据是好模型的第一性原理。多年沉淀的高质量数据,让U2-Flash后训练效果远超纯规模驱动的方案,成为国产模型“Flash时刻”的又一典型,进一步强化Flash主力智能的地位。
这条路上,国产模型达成了一种默契:用模型能力的增长降底千行百业使用算力的成本,他们不约而同开始聚焦Flash版,这才有了过去两个月国产模型Flash版本的集中爆发。两个月的集中爆发是结果,这个结果建立在对速度更快、成本更低、能力更强的持续追求。
实测中,云知声发现:U2-Flash内部试用接近一个月后,一个很明显的变化是,大家开始真正“放心把任务交给它”,最终结果的确定性都明显更高。这让他们重新思考“主力模型”的定义。主力模型并不一定意味着参数最大、单项能力上限最高,而应该是在绝大多数高频真实任务中,效果、速度、成本和稳定性达到最优平衡的模型。
3
用户侧:以更少 Token 交付同样甚至更好的结果
云知声的朋友告诉倪叔,他们内部有一个判断:随着Flash模型的任务完成能力不断提升,它会逐渐从一个“便宜版模型”变成企业真正高频调用的默认模型、主力模型。这与倪叔的个人观察不谋而合。
抛开内外局势不谈,只看结果,用户是最受益的。用户侧能以更少 Token 交付同样甚至更好的结果。Flash版的集中爆发最终也将加速千行百业的AI化。国外模型能力的提升带来了更高昂的 Token投入,国内却完全反着来。9月,云知声基于U2强化后训练推出U2 Flash,月之暗面在推出K3后反向推出更便宜推K2.8 Preview。共识正在重建。
国产模型的目标是:在更能打的同时让更多人用得起。
这是国产Flash模型集体努力的结果,也是云知声押注RSI的阶段性胜利。以云知声U2-Flash为例,原来可能需要几十步甚至上百步的长程任务,U2-Flash可以减少一部分无效步骤。内部统计显示,整体平均可以降低约20%~30%的任务迭代步数。两者最本质的变化,就是从“有能力做”变成了“能够以更短、更稳定的轨迹把事情做完”。
那这是不是意味着,未来Flash将彻底取代旗舰模型?答案是否。Flash承担的责任是普及,是让更多人、更多企业以更低成本获得更好更快的模型能力,但复杂的数学推理、前沿科研问题、高精度深度推理,以及空间等复杂关系理解等领域,依然是旗舰模型的主战场。
分工各不相同。
云知声认为,Flash 真正希望覆盖的是企业里的“高频工作负载”,例如文档分析和润色、表格和数据处理、会议纪要、方案生成与调研、代码理解和修改。云知声自身内部目前已经在上述多种场景中实际使用 U2-Flash。简单说就是,把Flash当成默认模型处理日常任务,把复杂任务交给旗舰模型。这将改写过去按“模型大小”做路由的方式。
未来模型路由的核心变量会逐渐从参数规模逐渐演变成变成根据任务类型、任务复杂度以及执行过程中的实时状态去做切换。
在能力构建方式上,U2-Flash 有两个鲜明立场:一是让模型深度参与自身训练闭环的演进——从生成训练数据、分析轨迹到巡检修复训练系统——这是递归自我改进(RSI)方向的重要实践,也是贯穿技术设计的主线;二是让模型在隐藏状态空间中进行深度思考,并将思考能力封装为用户可控的强度接口,而非不可观测的黑箱。
后训练加RSI双轮驱动,U2-Flash 通过自主闭环演进释放出高密度智能。这一切,立足于云知声在行业内的十余年深耕,海量真实场景数据与高质量标注能力的积累,成为U2-Flash 后训练提供了不可替代的数据质量壁垒,让U2-Flash的后训练效果远超纯规模驱动的方案。
抛开复杂的技术路线,参数对比,作为用户我们只需要知道:随着Flash版模型的爆发,大众用户、千行百业的企业,将以更少 Token 交付同样甚至更好的结果。从商业角度看,这将带来中国AI的极大繁荣。在中国模型厂商的努力下,未来AI的成本势必越来越低,效果却会越来越好。U2-Flash再一次用实力证明了,中国AI未来可期。

 加载中,请稍侯......