别再争谁是“中国版Duet”了,卖铲子的ICT厂商先赚到了钱

文 | Alter
硅谷大厂在 AI 应用层的新一轮抢位,已经把战火烧到了云端机房。
10 月 22 日凌晨,正处于 IPO 冲刺期的 Anthropic 发布了全新的个人与工作智能体应用 Claude Duet。
在此之前的一个多月里,Meta 旗下的 Muse、OpenAI 的 Dots、xAI 的 Grok Bot 以及华人创业团队打造的 Manus Cue 相继上线,几乎在同一时间交出了答卷:给 AI 在云端配一台独立的虚拟电脑。
在 Anthropic 公开的演示中,放出了一个有趣的场景:
每天早上 5 点 30 分,在一家咖啡连锁店的经营者起床前,Duet 已经自动从收银系统、Shopify 网店、客服邮箱、Gusto 薪资系统和银行账户中拉取完最新数据,生成了一份早间经营简报,并指出东湾地区因运费调整导致退订率从 2.6% 升至 3.4%。
Claude Duet 的亮相,迅速在科技圈引发了新一轮讨论:为什么国内没能跑出一款能够跨平台的“中国版 Duet”?
倘若把视线从应用层的入口之争移开,落到更底层的产业链上,会看到另一番图景——最先感受到常驻型 Agent 浪潮冲击、最先兑现商业价值的,不是台前的 AI 企业,而是水面下的基础设施层。
一位国内头部云厂商的架构师坦言,当 AI 的产品形态从“一问一答的聊天框”变成“24 小时在线的云端虚拟机”,数据中心里的计算、存储与网络配比,都要推倒重算。
01 从对话框到云电脑
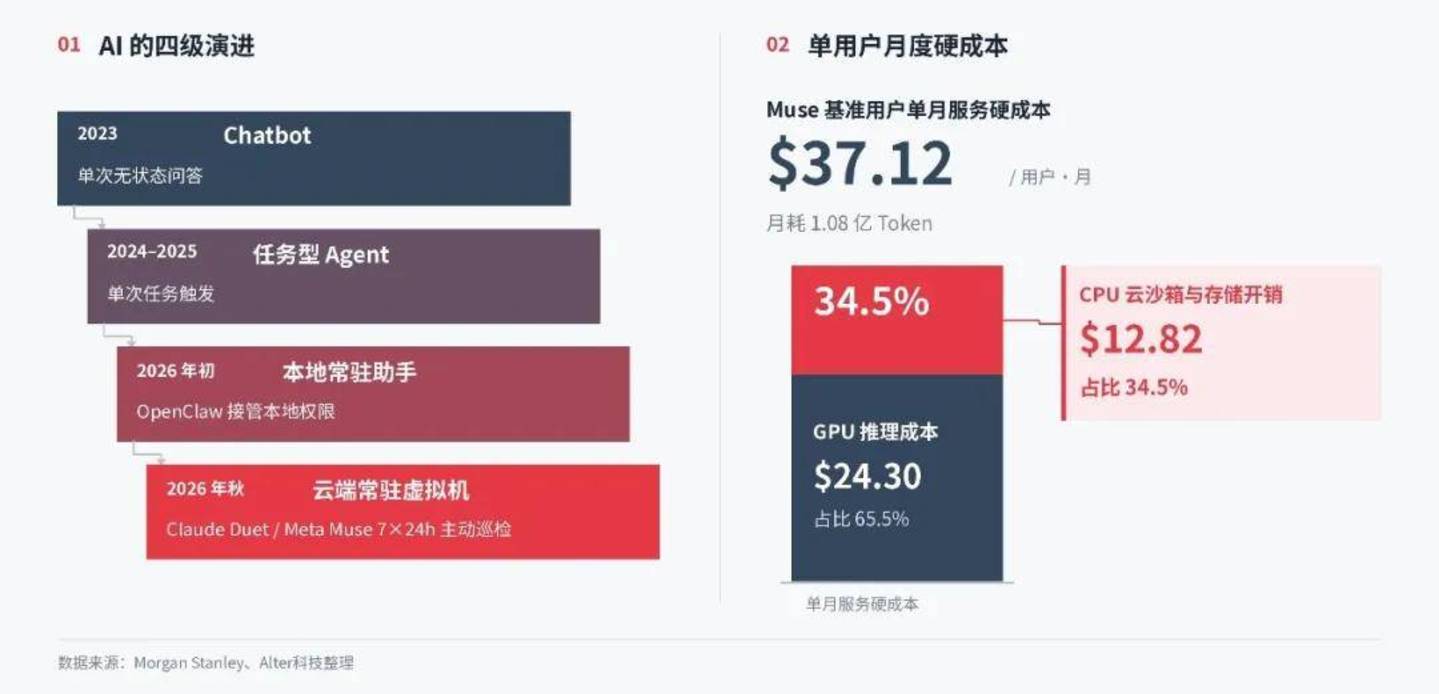
把过去四年的 AI 应用演进放在一条时间线上观察,产品形态已经走过了四个阶段。
2023 年是 Chatbot 阶段:ChatGPT 定义了问答交互,模型负责生成文字或代码,具体的执行动作仍由人来完成。
2024 年至 2025 年进入任务型 Agent 阶段:初代 Manus 与 Claude Code 证明了 AI 可以拆解多步骤任务并交付结果,但交互仍是单次触发,任务结束会话随之清零。
转折发生在 2026 年初。
开源框架 OpenClaw(因图标与名字谐音,在国内开发者圈被称为“小龙虾”)在三个月内拿下 GitHub 24 万星标,腾讯、字节、阿里等国内大厂迅速跟进,打造了一个个“活”在用户电脑里的 AI 助手。
时间来到 2026 年秋,Meta Muse、Grok Bot 连同刚发布的 Claude Duet,将协作逻辑推向了云端:
智能体不再占用用户的本地电脑,而是在云端拥有独立的运行环境(Meta 甚至为每位 Muse 用户分配了一台专属虚拟机),并普遍引入了“主动巡检”机制——不等用户下达指令,系统每隔几个小时就会在后台自动唤醒,检查邮件、日历和业务系统。
对用户来说,是从“被动工具”到“主动管家”的体验升维;对底层的算力基础设施,则意味着负载发生了根本改变。
传统的 Chatbot 是无状态的,用户提问时调用一次 GPU,回答结束连接即断开,夜间流量自然回落。而常驻型 Agent 是有状态的,以 Meta Muse 为例,底层由多个“工作子代理”平行运作,同时配有一个独立的“Sentinel 审查代理”在后台监控权限与安全。
这种变化将直接推高单个用户的服务成本。
9 月 30 日,摩根士丹利互联网首席分析师 Brian Nowak 团队发布了一份针对 Muse 的单位经济模型测算:在仅使用每周免费 Token 配额 25% 的基准情景下,单个活跃用户每月大约消耗 1.08 亿个 Token,对应每月 37.12 美元的直接服务硬支出——其中 24.30 美元为 GPU 推理成本,12.82 美元为 CPU 沙箱环境与存储开销。
在重度开发者群体中,数字更加惊人。
OpenAI CEO 萨姆·奥特曼曾在 6 月份公开透露,OpenAI 内部使用量排名第一的工程师单月消耗达 1000 亿 Token。当常驻型 Agent 可以在云端 7×24 小时工作,1000 亿绝不是月 Token 消耗量的上限。
把这条时间线拉长,会发现一个容易被忽略的细节:每一次产品形态的跃迁,都伴随着算力账单的转手。
Chatbot 时代,账单按次结算;“小龙虾”时代,智能体跑在用户自己的电脑上,电费与硬件折旧由用户默默承担;到了云端常驻阶段,账单又被整体搬回了 AI 厂商与云厂商的资产负债表。
常驻型 Agent 的竞争变量正在从“模型有多聪明”,转向“养一个活跃用户每月要花多少钱”。所谓“主动巡检”,本质上是一个成本旋钮:巡检越频繁,体验越像管家,单用户成本也越高。谁能在体验与成本之间找到可持续的平衡点,谁才可能把这门生意做下去。
而在这个问题被回答之前,最先确定拿到钱的,是卖铲子的人。
当海量智能体在云端持续运转,数据中心里最先告急的,并非过去三年备受追捧的 GPU。
02 CPU 重回牌桌中央
过去三年,AI 算力市场的主角一直是 GPU。
在传统的大模型训练和单次推理服务器中,CPU 与 GPU 的配比通常在 1:4 到 1:8 之间。GPU 负责高密度并行矩阵运算,CPU 仅承担数据搬运、基础调度等任务。
以 Meta Muse 为代表的常驻型 Agent,正在打破既有配比。
一个 Agent 接到任务后,需要经历意图理解、任务拆解、拉起安全沙箱、执行代码、操作浏览器、调用外部 API、验证结果及反思重试等多个步骤。除了“模型推理”的一小段由 GPU 完成,绝大部分流程控制、工具调用与环境隔离,都属于典型的串行逻辑运算,由 CPU 承担。
云端虚拟机的普及,将进一步推高 CPU 核心的需求。
比如 Meta Muse 在云端为每位用户配置了一台标配 2 个 vCPU、8GB 内存和 100GB SSD 的 Linux 虚拟机。
海外硬件媒体 Wccftech 曾按静态峰值做过一次推算:若 Muse 扩展至 1 亿用户且每人独占物理核心不共享,按单颗 126 核 AMD EPYC 处理器计算,仅此一款应用就需要 158 万颗服务器 CPU。
当然,在实际工程中,云厂商并不会让虚拟机 24 小时空转。
可即便计入休眠机制与多倍超售比,当数千万活跃用户在高峰期并发拉起多个子 Agent 临时沙箱时,数据中心对独立“Agent CPU 机架”的需求依然显著增长。
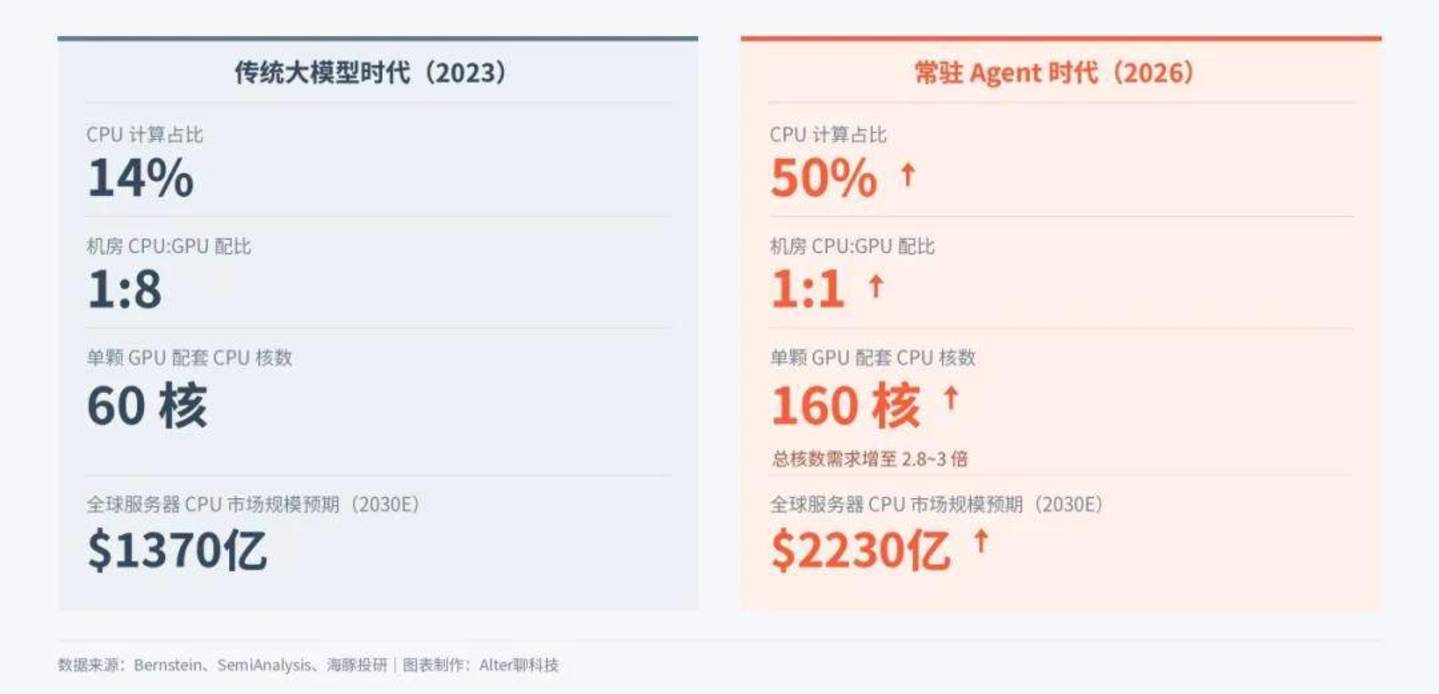
伯恩斯坦(Bernstein)在研报中判断,智能体负载中 CPU 的计算占比将从传统大模型的 14% 升至 50%,CPU 与 GPU 配比正从 1:8 向 1:1 收敛,并将 2030 年全球服务器 CPU 市场规模预期上调至 2230 亿美元。
需求的变化已经传导至供应链。
KeyBanc 的数据显示,受大型云服务商集中采购影响,英特尔与 AMD 在 2026 全年的服务器 CPU 产能已基本售罄,两家公司均计划将服务器 CPU 价格上调 10% 至 15%,交付周期已从常规的 1~2 周拉长至 8~12 周,部分型号自年初以来涨幅超过 40%。
面对高昂的 CPU 成本与高并发沙箱需求,国内云与服务器厂商纷纷在 2026 年加快了底层架构改造:
阿里云上线了基于微型虚拟机隔离的 ACS Agent Sandbox(智能体沙箱),重点优化大规模低延迟弹性拉起与低成本状态保持。
腾讯云在 7 月开源了 Cube Sandbox v0.5.0,联合 Arm 工程团队完成了 Arm 架构的原生主线支持,使 Arm 平台在沙箱创建速度、状态恢复耗时与单机并发密度上追平 x86。
新华三提出了基于 CXL 内存池的沙箱镜像池方案,将常用操作系统与依赖库预先常驻于共享内存层,新沙箱拉起时无需读取磁盘,直接通过内存映射实现零拷贝启动,将沙箱冷启动时间从秒级压缩至毫秒级。
在 CPU 涨价、交期拉长的背景下,单机能塞下多少个沙箱、休眠后多快能唤醒,直接决定单用户成本。产业价值正在从“卖更多核”,迁移到“让每个核跑更多 Agent”。
03 当显存被撑爆之后
与 CPU 一同迎来价值重估的,还有长期处于数据中心边缘的存储系统。
在传统云计算架构中,存储主要负责静态保存数据,毫秒级的读写延迟即可满足业务需求。
但在长程 Agent 场景下,存储直接进入了计算主路径,核心瓶颈变成了 KV Cache。
就像在 Claude Duet 的演示场景中,为了协助用户准备 A 轮融资路演,Agent 需要连续读取 25 份数据室文档、6 位投资合伙人的背景资料,并进行数十轮工具调用。
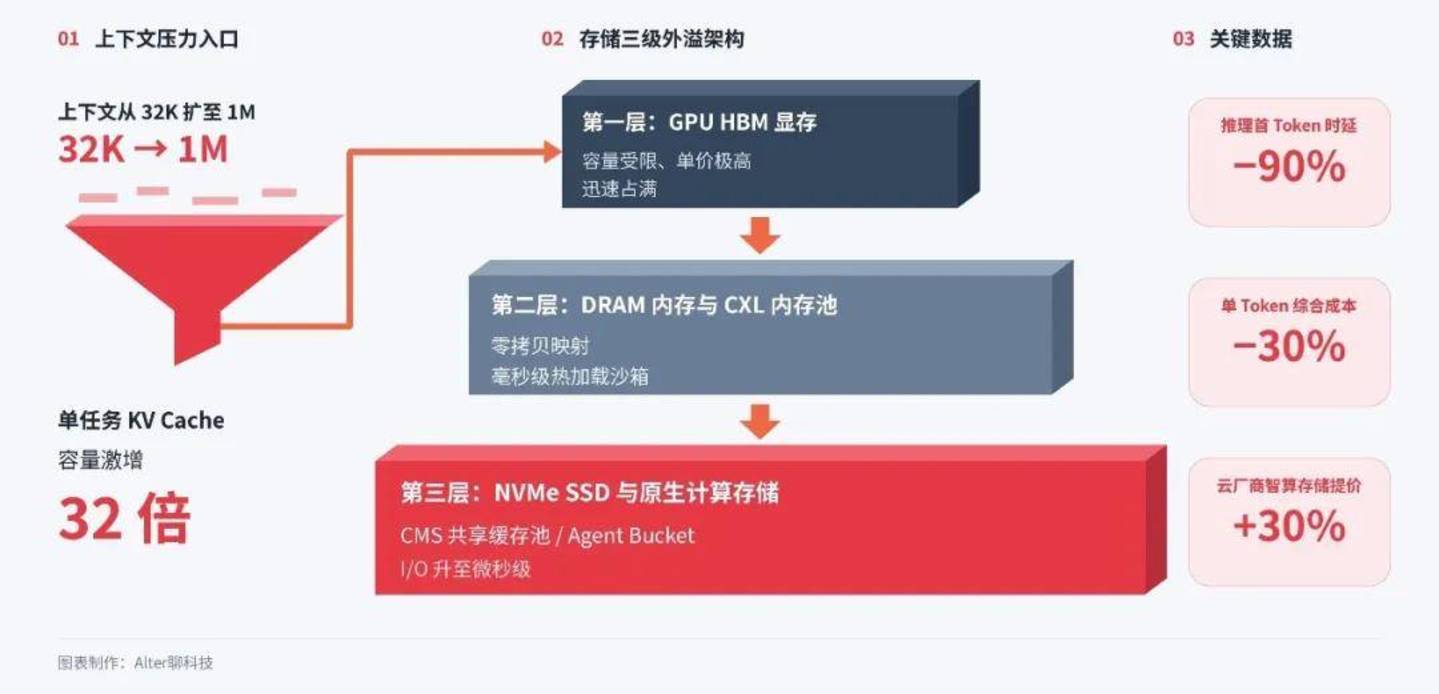
随着模型上下文窗口扩展至百万级,且多轮慢思考成为常态,单任务链条下的 KV Cache 容量需求激增了几十倍。
容量有限且价格高昂的 GPU 高带宽显存(HBM)很快被占满,溢出的温热 KV Cache 与长期记忆数据,不得不向下一层级的 DRAM 内存、CXL 内存池以及企业级固态硬盘(NVMe SSD)下沉。
除此之外,数以亿计的云端沙箱在执行“快照休眠与唤醒恢复”时,也需要高频读写各自的独立文件空间。
华为数据存储产品线副总裁吴俊杰在媒体采访时表示,当 Agent 以 7×24 小时不间断的方式访问上下文时,底层存储的时延要求已经从过去的毫秒级提升到了微秒级——任何一丝数据返回延迟,都会导致 GPU 等待空转;若因缓存空间不足被迫截断上下文,就必须进行大量重复计算。
供需关系的紧绷,已经反映在了价格与财报上。
国内 DRAM 厂商长鑫科技在 2026 年前三季度业绩预告中表示,受 AI 算力需求拉动,DRAM 产品供不应求、价格大幅上涨,公司产能利用率保持高位;存储模组龙头江波龙则预计 2026 年前三季度实现营收 380 亿~400 亿元(同比增长 127%~139%)。
为了缓解“显存墙”与亿级沙箱的存储隔离难题,国内的科技大厂也在推进存储架构重构。
华为推出了支持异构算力的 CMS(上下文记忆存储)与 UCM(统一缓存管理)方案,通过专用 DPU 语义卸载构建 PB 级共享 KV 缓存池,使推理首 Token 时延最高降低 90%,单 Token 综合成本下降约 30%。
腾讯云在 7 月发布了业内首款面向智能体场景的原生存储 Agent Bucket。通过在存储桶下引入独立的“Space”空间单元,将单个 Agent 的凭证隔离、容量配额与读写限速从业务代码层下沉至系统底层,配合 GooseFS 分布式缓存应对高频小文件访问。
如果说 CPU 需求取决于消费级 Agent 能否跑通商业模式,存储的逻辑则更为扎实。长上下文与多轮推理并非常驻 Agent 独有,企业级 Agent、编程 Agent 乃至普通的深度推理任务,都在推高 KV Cache 的规模。即便某款明星应用增长放缓,存储需求也不会退潮。
更深层的变化在于,存储正在“用容量换算力”:缓存留得住,GPU 就少做重复计算;留不住,就得拿更贵的 GPU 时间来补。存储由此从成本项变成了效率项,在 AI 基础设施中的话语权不断上升。
04 倒过来的网络漏斗
计算与存储之外,通信与数据中心网络同样在经历一场流量结构的逆转。
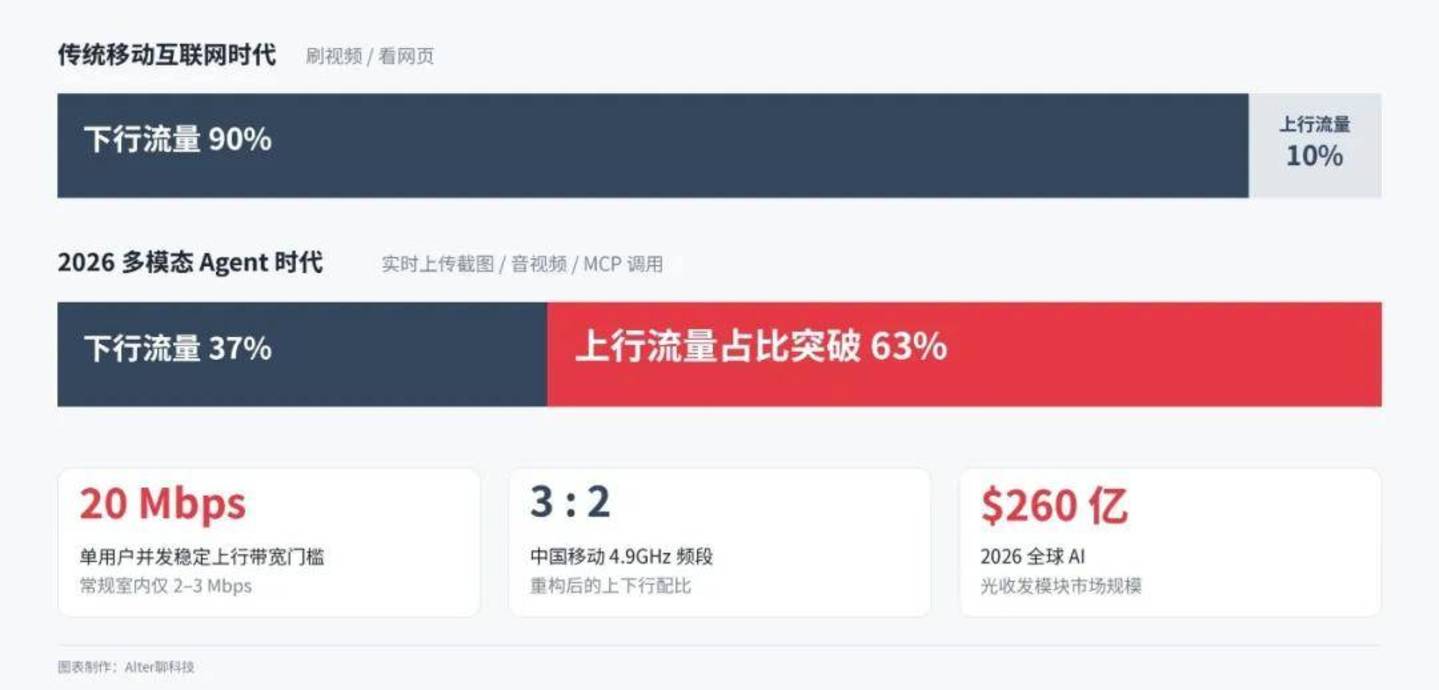
过去二十年,互联网主要围绕“人消费内容”设计。用户浏览网页、观看视频、下载应用,数据流向以机房下发至终端为主,传统场景下网络上行流量占比通常仅为 10% 左右。
在 Agent 场景下,流量结构被倒置了。
无论是云端 Agent 持续读取本地工作流,还是用户通过手机、智能眼镜向 Agent 实时传输高清截图、音视频流与文档,AI 执行任务的前提是终端向云端高频上传上下文。
比如年初的 MWC 2026 上,华为披露了上海某美术馆的实测数据:引入多模态 AI 智能体作为导览员后,每天有超过 3000 名观众上传展品照片或视频进行交互,网络上行流量占比首次突破 60%。
在数据中心内部与跨云协同场景中,机器对机器(M2M)的通信密度也在同步攀升。
一个典型的例子:当 Claude Duet 在后台生成一份经营简报时,数分钟内需要通过 MCP 协议连续调用十余个外部 SaaS 系统的 API;而在机房内部,分立部署的“Agent CPU 机架”、“GPU 推理机架”与“CXL 存储机架”之间,需要时刻进行高带宽、低延迟的状态同步。
面对千亿级的 Agent 连接预期,国内通信与网络产业链早已开始调整布局:
在运营商侧,中国移动正在探索于 4.9GHz 频段将上下行流量配比调整为 3:2 以匹配智能体上行需求,并提出了无损智算光网络(HIC-OTN)架构;中国联通则在 9 月将传统 CDN 升级为 AICDN,实现 AI Token 算力与边缘内容的协同调度。
在硬件与边缘服务侧,数据中心对 800G 及 1.6T 高速光模块的需求持续放量,TrendForce 预估 2026 年全球 AI 光收发模块市场规模将达 260 亿美元。
需要说明的是,网络侧的变化方向虽然清晰,兑现节奏却很可能落后于计算与存储。调整频谱配比、建设无损光网络,周期以年计,投入必须先于需求;而目前关于上行流量反转的实证,仍主要来自个别场景的测试。
真正值得关注的是运营商的角色。
很长一段时间里,网络按下行带宽设计、按内容分发收费;如果 Agent 让上行成为主流量,“上行”本身就可能成为新的计费维度。运营商未必最先受益,却可能握有最长期的定价杠杆。
05 写在最后
回到开头的问题。
中国市场短期内恐怕难以跑出一款跨平台的“中国版 Duet”,症结不在技术,在于生态边界:截至 10 月下旬,已有包括微信、淘宝、支付宝、美团在内的上百款应用拒绝了豆包手机助手的屏幕自动化操作,跨 App 代理在国内首先是一道商业题。
由此构成了一个耐人寻味的错位:
应用层的入口之争在国内暂时僵持,而由全球 Agent 浪潮拉动的 CPU 扩容、存储升级与算力网络改建,已经让中国 ICT 产业链上的基础设施厂商先一步拿到了订单。
但红利的成色,最终仍取决于应用层:只有当常驻型 Agent 找到“养得起用户”的商业模式,今天的扩容才不会变成明天的过剩。

 加载中,请稍侯......