AI进展观察|个人与企业研发 Agent,功能到底差在哪?

作者介绍:
陈晨,奇安信副总裁、高级工程师、客户战略委员会委员,曾分管数字化与采购。一个浸泡在数字化和智能化行业里的老兵。
同一个研发 Agent,个人侧在解放能力,企业侧在收束不确定性。
上一篇,我们用"个人/企业 × 国内/国际"四个象限,看清了研发 Agent 的市场格局。这一篇往功能层走:个人用的研发 Agent 和企业用的研发 Agent,到底差在哪里?
一种常见的理解是:企业版 = 个人版 + 更多席位 + 更贵的价格。这是一个误解。
真正的差异,不是功能数量的多少,而是约束条件的不同:个人 Agent 的目标是尽可能解放个人的能力,企业 Agent 的目标是把模型的不确定性装进一个可控、可信、可审计的框架。
下面从八个维度逐项拆解。需要说明,个人与企业并非非黑即白,头部产品都在沿这条路径演进,但二者的能力边界有本质区别。
一、任务边界:从"写好一段代码"到"编排整个研发流程"
个人 Agent 处理的是局部任务。补全一行代码、生成一个函数、修改一个文件、修一个报错、完成一个 Side Project,范围基本在 IDE 或终端内,由开发者一步步驱动。
企业 Agent 要编排完整的软件开发生命周期(SDLC)。从需求分析、架构设计、编码、测试、评审、部署到运维,任务往往跨多个仓库、多个团队,是长周期、高复杂度的异步执行。
这也正是 Gartner 把品类从"代码助手"改名为"代码智能体"的原因:竞争的焦点从"单次补全节省时间",变成"谁能在整个生命周期中编排工作"。
二、上下文:从"打开的文件"到"整个代码库与历史"
个人 Agent 的上下文是有限的。主要是当前打开的文件、附近的代码和单个仓库,超出窗口的历史它看不到。
企业 Agent 必须理解整个代码库。企业往往有数十万到数千万行的历史代码、复杂的跨仓库依赖、长期积累的架构规范。Agent 要先为代码库构建结构化的知识图谱(如词元无限的 DeepMap),才能理解"这段代码为什么这么写",而不只是"这一行该怎么写"。华为 CodeArts 强调支持数千万行规模的代码库,正是这一能力的体现。
能否吃透大型代码库,是个人与企业的第一道分水岭。
三、自主性与权限:从"我自己说了算"到"分级授权与审批"
个人 Agent 没有组织概念。它装在个人电脑上,读写自己授权的文件,谁安装谁就是管理员,权限边界就是这个人自己的边界。
企业 Agent 则建立在组织架构之上。按部门、角色分配权限,销售能看的代码,财务不一定能看;哪些操作 Agent 可以自主完成、哪些必须人工审批、哪些只有人才能做,都需要明确的分级授权和审批闸门。
这里有一个关键的定位演进:当 Agent 只是"助手"时,它默认借用员工自己的权限,权限无限接近员工本人;而当 Agent 承担完整流程、被当作"AI 员工"时,就必须为它单独定义权限、并对所有操作做审计。从"AI 助手"到"AI 员工",权限模型发生了根本变化。
四、执行面:从"在我电脑上跑"到"受控沙箱与受限凭证"
编码 Agent 有一个特殊之处:它的执行面是任意 shell 命令。这意味着权限设计必须格外谨慎。
个人 Agent 直接在本机运行,继承本地环境的权限。对个人使用,这没有问题。
企业 Agent 必须运行在受控环境中。容器或虚拟机沙箱隔离、CI 场景下持有 CI runner 的受限凭证,保证它够不到生产凭证。安全实践还包括三条原则:给 Agent 独立的"影子身份"而非员工主身份、按任务逐项授予凭证而非给全权 token、把不可逆操作的确认逻辑写死在工程(Harness)层而非提示词里。
这样做的好处是:出事时可以一键吊销 Agent、不影响本人,审计日志也能天然区分人和 Agent 的操作。
五、工具集成:从"IDE 里的工具"到"连接整个研发工具链"
个人 Agent 主要与 IDE、终端和本地环境打交道。它是一个相对独立的工具。
企业 Agent 必须连接整个研发工具链。Git 与代码仓库、CI/CD 流水线、需求与缺陷管理(如 Jira)、代码扫描与安全、监控与可观测、企业身份与权限系统。它的价值恰恰来自嵌入既有的生产流程,而不是成为又一个孤岛。
能否打通这些系统,决定了 Agent 产出的代码能否真正进入交付。
六、安全与部署:从"代码上云"到"数据不出域"
个人 Agent 通常是云端 SaaS,按月订阅,代码可以上传到云端处理。对个人而言,这是便利与成本的平衡。
企业 Agent 则把数据边界作为硬约束。"源代码不出研发网"是很多企业的红线,因此需要私有化部署、自托管、VPC 内网或专线受控通道;模型策略上往往不与单一厂商绑定,支持多模型接入甚至自有模型。这也解释了一个行业现象:在头部产品中,SOC 2、SSO/SCIM 等合规基线已基本标配,但自托管仍然稀缺——对受监管行业,能否私有化部署才是真正的门槛。
七、质量与确定性:从"错了再改"到"必须可验证、可追溯"
个人场景容忍试错。生成的代码有问题,开发者自己发现、自己改,成本由个人承担。
企业场景容错率极低。一个漏洞、一次误合并,都可能造成实际损失。因此需要一整套质量保障:自动测试、人工评审、多 Agent 交叉校验、质量门禁、失败回滚,以及完整的审计日志。
上一篇已经列出各家的评审率差异:Copilot、Cursor 被合并的工作几乎全部送审,而 Codex、Devin 大量 PR 无第二评审即合并(具体数据见上一篇)。这组数字背后,是企业级质量保障的不同。
企业真正要建的,是一套分层的质量机制:代码提交前由 Agent 自动测试和多 Agent 交叉校验,提交后进入质量门禁,不满足标准无法合并;高风险变更必须人工确认;一旦上线出现问题,能快速回滚;每一步操作都写入审计日志,事后可追溯。这套机制决定了企业在什么条件下,才敢于让 Agent 自主合并。
八、协作与治理:从"单 Agent"到"多 Agent 组织与可度量"
个人 Agent 是单 Agent 与个人的交互,基本没有治理需求。
企业 Agent 则是组织级的生产系统。它需要多个角色的 Agent 协作(架构师、程序员、测试、评审),需要 Agent 与人、Agent 与 Agent(A2A)之间的协同,跨系统调用时还要保证用户身份沿链路透传。
更重要的是可治理:团队用了多少、花了多少算力、产出多少、ROI 如何,都要可度量、可核算;全链路操作可观测、可回放。这正是企业把 Agent 从"试点预算"推进到"生产基础设施"的前提。
个人能力栈简单,企业能力栈复杂——差异的本质是约束条件不同。
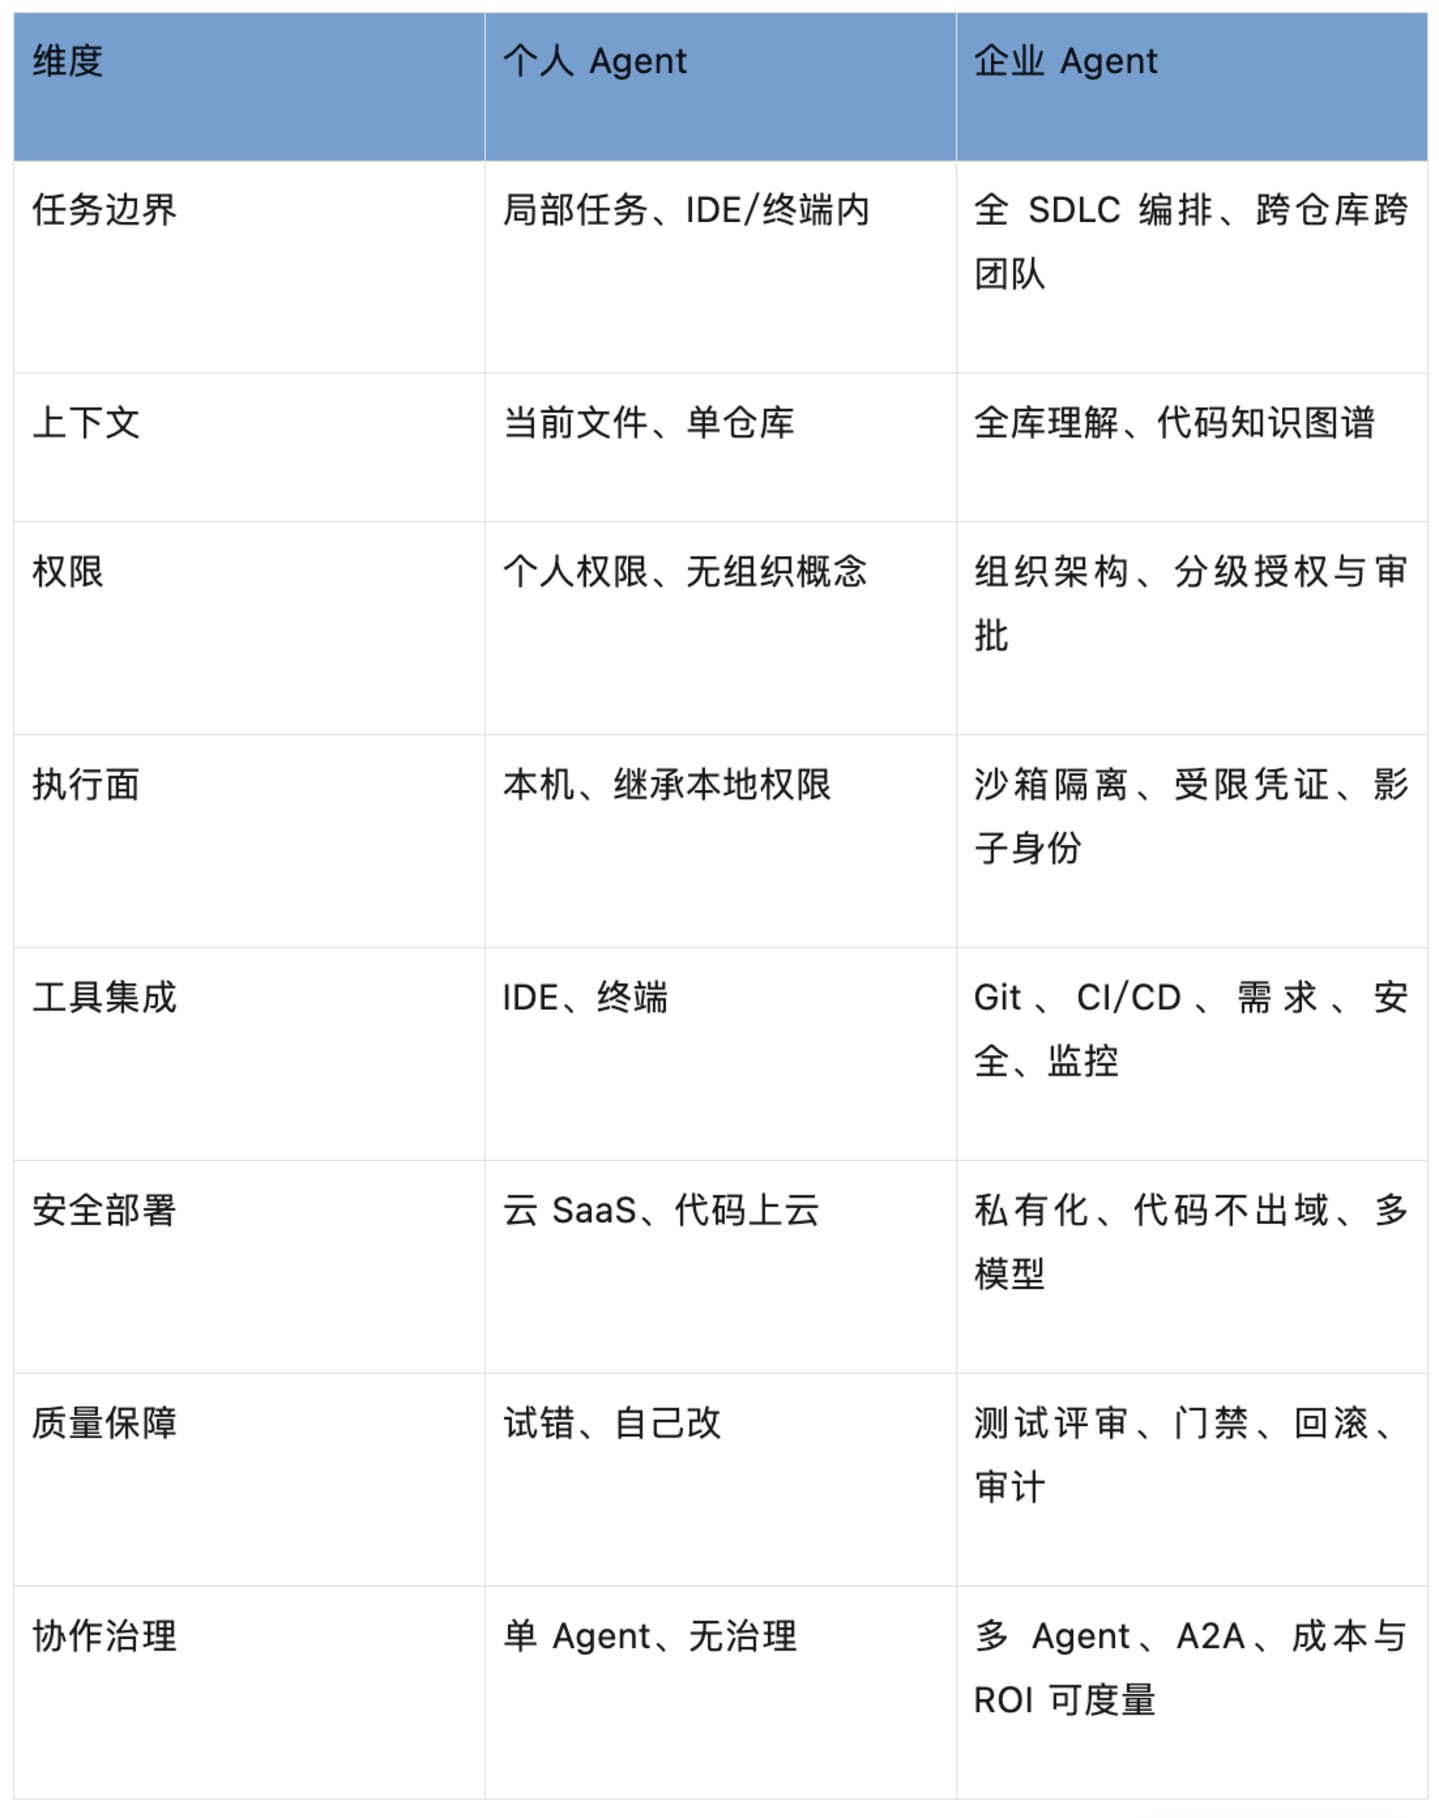
一张表看全:八个维度的功能差异
结语:一个在"解放",一个在"收束"
回到最初的问题,个人与企业研发 Agent 的差异,本质上不是"功能多少",而是约束条件不同:个人 Agent 尽可能解放个人能力,企业 Agent 则把模型的不确定性收束进可控、可信、可审计的框架。
更值得关注的是演进方向。当前大多数企业还停留在"AI 助手"阶段,Agent 借用员工权限辅助提效;而当研发流程走向全链路 AI 化,Agent 将成为"AI 员工",需要独立的权限定义、全流程审计和组织级治理。这正是功能差异未来的核心。
需要说明的边界是:个人与企业并非截然割裂,头部产品都在向企业侧演进;本文的功能描述基于公开报告与产品资料,具体能力随版本快速迭代,选型时应以实际产品和部署方案为准。
引用文档
Amplifying《代码智能体市场现状(State of the Coding Agent Market)》(2026-10)
Gartner《2026 企业级 AI 代码智能体魔力象限》(ChatForest 解读,2026-05)
腾讯云开发者社区《当我们谈论 AI Agent 时,我们谈论的是同一个东西吗?——企业视角下的 Agent 分类、部署与权限设计》(2026-07)
钛媒体《成立 1 年融资 3 轮,前字节女高管创业,跑赢 GPT-5 登顶编程榜》(2026-07)
人民网《词元无限:以“全自主、高安全、自进化”重写 AI 原生企业的底层逻辑》(2026-07)
东方财富《2026 中国智能体经济白皮书》(2026-09)
本文为“AI 进展观察”系列中立分析,不构成任何产品推荐或投资建议。

 加载中,请稍侯......